以簡單的方式重建數據工程底座
LongData 把複雜而易錯的機制收進系統,留下簡單、明確、可驗證的工作面,並用獨立於智能體的確定性驗證證明每一次結果。讓工程師的工作變簡單的這些設計,正是智能體需要的工作環境。
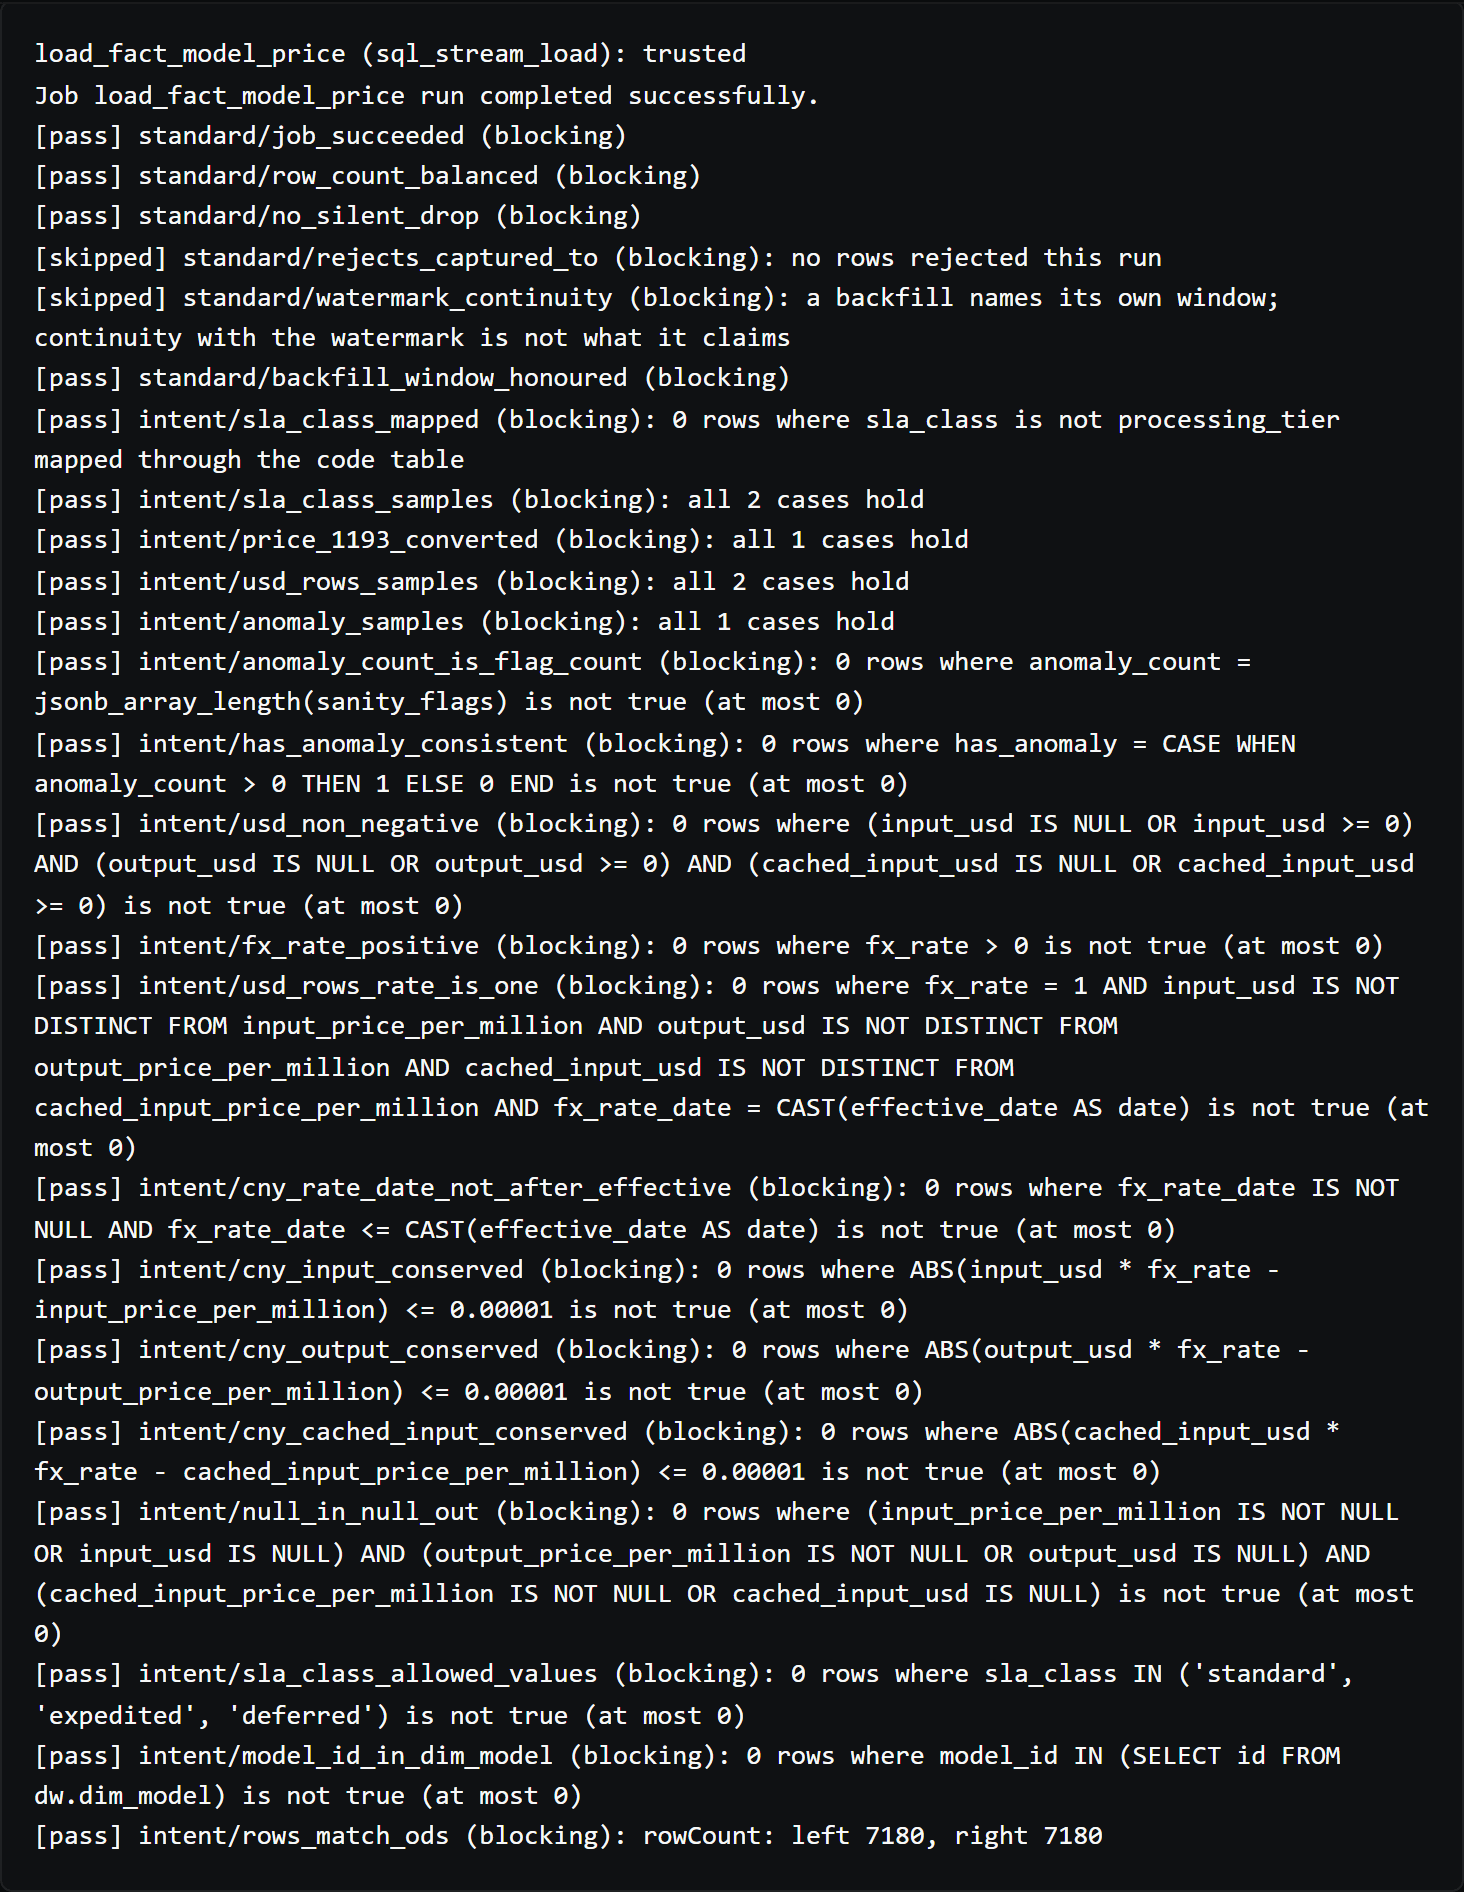
一次真實運行:智能體編寫的作業,平台對每一項運行保證與驗收條件給出的裁決。
行業現狀
數據工程正在進入智能體時代
數據工程與軟件工程有一個關鍵差異:代碼可以從編譯、測試和運行結果中得到大量確定性反饋,數據工程的程序即使運行成功,結果仍然可能是錯的。這類錯誤不以報錯的形式出現,往往在數月之後的對賬中才被發現。會產生幻覺的模型不會減少這類錯誤,只會讓它們出現得更快、更多。
投入增加,資源仍然緊張
Deloitte 的 2025 年 CDO 調研顯示,54% 的受訪者在過去一年擴充了數據團隊,63% 預計下一年繼續擴充;48% 仍將預算和資源限制列為 AI 應用的主要挑戰。
維護佔用一半工程時間
Fivetran 對 500 名大型企業數據與技術負責人的調研顯示,工程團隊平均將 53% 的時間用於維護數據管道。
Fivetran《Enterprise Data Infrastructure Benchmark 2026》|500 名大型企業負責人 ↗
AI 主要加快了編碼
dbt Labs 對 363 名從業者與管理者的調研顯示,72% 優先考慮 AI 輔助編碼,僅 24% 優先考慮包含測試、可觀測性和質量控制的管道管理。
質量和治理仍是基礎
BARC 對 1,795 名參與者的全球調研中,數據質量管理位列第二,數據治理位列第四;AI 與自動化沒有取代這些基礎能力。
現有數據工程體系為人類工程師設計,它的複雜性交給智能體之後,就成了幾乎沒有邊界的動作空間。LongData 的判斷是:智能體能否承擔數據工程,關鍵不在模型本身,而在它工作的環境。
設計範式
三次分離:計算與存儲、計算與程序、計算與語義
計算與存儲分離已被業界驗證,計算與程序分離、計算與語義分離由 LongData 作為範式提出。SQL 在程序與計算引擎之間劃出了一條穩定、精確的邊界;LongData 的意圖在業務方與實現者之間劃出另一條:業務方定義什麼結果是對的,AI 編寫實現,引擎完成計算,平台負責裁決。
計算與存儲分離
計算不再綁定特定的數據存儲。存儲與計算獨立擴展,已成為現代數據平台的基本架構。
計算與程序分離
全部計算從應用與數據管道中抽離,交給數據庫與計算引擎。程序只充當膠水與協調控制,不承擔計算。
計算與語義分離
業務需求,包括目標、口徑、業務邏輯、規則、碼值與驗收標準,從 SQL、腳本和執行實現中抽離。實現可以重新生成和替換,業務語義成為長期資產。
計算與程序、計算與語義這兩次分離之後,數據工程程序變得簡單得多。這是智能體能夠可靠地生成項目作業的原因,也是它從輔助編寫管道走向完成數據工程的前提。
產品概覽
LongData 由五個部分組成
LongData 不是在傳統 ETL 系統之上增加 AI,而是以簡單的方式重新設計的一套數據工程底座,智能體在這個底座上完成開發。
確定性執行內核
增量、窗口、併發、冪等、刪除、故障恢復、批量處理、運行記錄與運行前檢查等通用機制由框架統一實現,每一次運行的行為確定、可復現。
意圖
業務需求的機器可讀形式:由智能體從業務方的需求文檔翻譯而來,獨立於實現,按開放標準書寫,版本化管理。
agent 循環
智能體從業務方的需求文檔出發,編寫、運行、驗證並修正,直至交付一個完整的項目。
技能
承載平台的工程知識與企業自己的業務知識,經人工簽字後供給智能體;企業的業務知識一經簽字,在它的所有項目之間複用。
證據
每一次開發、運行、裁決與簽字都自動留下記錄,構成可審計的證據鏈。
產品價值
核心價值有兩條,確定性驗證是讓這兩條能被放心採用的保證
核心價值
運行更快
性能在設計時一次決定,智能體在這套設計之內編寫。批處理作業的耗時可以從小時級降到分鐘級,管道 7×24 小時以連續微批運行,延遲達到秒級。
核心價值
開發更省人
需求分析、編寫、測試、修正與對賬這些原本需要工程師排期數週的工作,由智能體在開發環境中完成。業務分析師提交一份需求文檔,即可得到一個完整、經過驗證的項目。
保證
每一個結果都經過校驗
驗收標準由業務方設定,裁決由平台執行,智能體無法改變裁決方式。執行前的檢查不通過,作業不會運行,數據不會被改動;執行後,平台針對這次處理的數據逐項裁決。
交付流程
從需求文檔到完整項目
agent 循環讓會產生幻覺的模型在有限的預算內穩定收斂:智能體從業務方的需求文檔出發,交付一個經過驗證、可以上線運行的完整項目。
需求文檔
業務分析師用業務語言寫清目標、口徑、碼值定義與判定樣本,不受任何模板約束。需求文檔由人簽字,是項目的語義源頭。
開發與驗證
智能體把需求文檔譯成項目的總體意圖,逐層分解,直到每個目標可以由一個作業完成;為每個作業選用工具或生成實現,在開發環境運行,讀取裁決,在出錯的地方修正。
語義缺口上報
一個沒有定義的碼值、一個沒有說明的口徑,智能體不會猜測,而是停下並提交工單,由業務方答覆。表結構的變更經工單交給 DBA。
簽字與生產
平台凍結交付所運行的全部文件,在凍結的文件上從頭重放整個項目,業務方依據完整的證據鏈籤一次字。生產環境只運行簽過字並晉升的版本,完全確定,沒有 AI 參與。
運行裁決
每一次運行針對它處理的這批數據逐項裁決;阻斷級條件不成立,結果標為不通過。
- 通過
schema_compatible執行前:目標可以無損地容納每一個源值
- 通過
source_fully_read窗口內的源數據全部讀到
- 通過
row_count_balanced源讀 = 目標寫 + 刪除 + 拒絕 + 過濾
- 通過
rejects_captured_to被拒絕的行連同原因一併落庫
- 不通過
codeMap源端出現碼值表以外的值,作為語義缺口上報業務方
運行保證由各類作業自帶,業務條件寫在意圖中。裁決由平台執行,智能體可以讀取裁決,但無法改變裁決方式。
平台能力
平台內置的數據工程能力
智能體可靠的根本原因在於動作空間有界:數據工程中細節最多、最容易出錯的機制,已經作為經過生產驗證的能力沉澱在平台裡。
數據同步與裝載
全量與增量同步,按主鍵合併寫入,跨系統的大批量裝載。源端刪除的數據按意圖的聲明在目標中標記或移除。
連續運行
管道 7×24 小時以連續微批運行,每一個微批取到源端最新的變更。
數據加工
碼值映射、表達式計算、跨表關聯與匯總下推到數據引擎執行;超出 SQL 能力的加工寫成獨立的加工代碼。
對賬
從行數核對到逐行比對,深度可選,兩端可以位於不同的系統,也可以獨立用於審計並非由本平台建設的管道。
元數據目錄
自動採集各數據源的庫、表與欄位並持續更新,是智能體編寫與平台檢查共同依據的事實來源。
表結構變更
建表與改表始終由 DBA 執行。寫入之前,平台檢查目標能否無損地容納每一個源值。
管道
多個作業組成管道,以編舞方式運行:增加或刪除節點互不影響,運行不依賴中央調度器和外部協調服務,可以跨引擎、跨雲遷移。
數據工程開發技能
平台隨安裝提供一整套數據工程開發技能,是多年數據工程實踐的積累,指導智能體規劃、設計與編寫每一個作業。
治理、血緣與數據資產
治理所需的記錄在每一次正常運轉中自動產生:數據血緣無需人工登記,每一批數據可以追溯到產生它的意圖、實現與運行;元數據、語義、證據與能力四類資產隨使用持續沉澱。
運行裁決
每一次運行都經過裁決
LongData 不把可信定義為 AI 聲稱自己的結果正確。可信意味著:一個數據工件能夠證明自己滿足企業已經明確聲明、版本化並授權採用的一組要求。
執行前攔截不可逆的損害
寫入會導致截斷、類型變化,或者把空值寫進非空欄位時,作業在運行前即被拒絕,並指明問題欄位。
業務條件與運行保證
每一次運行都針對它處理的這批數據裁決:業務條件寫在意圖中,運行保證由各類作業自帶。
對賬深度可選
從行數一致、各欄位匯總值與空值數一致、主鍵一一對應,直至逐行比對。「可信到什麼程度」由此成為一個可度量、可交付的產品屬性。
驗證只能加強,削弱必須留痕
業務方增加驗收條件,可信度只會提高;刪除已聲明的條件需要重新簽字,關閉運行保證必須寫明理由並在報告中列出。
可信不是永不出錯,而是始終明確當前結果被驗證到了什麼程度。
面向的角色
產品面向的第一角色是業務分析師
業務分析師同時掌握業務語義與技術理解,既懂口徑與規則,也懂表與欄位;LongData 讓業務分析師不必再把需求轉交給數據工程師。
業務分析師與數據分析師
用業務語言寫需求文檔,不寫 SQL,得到一個經過驗證的完整交付。
數據工程師
智能體無法獨立完成開發時開出工單,數據工程師隨即介入,找到問題所在,新增或改進技能,幫助智能體完成開發任務。
DBA
表結構與元數據目錄仍由 DBA 掌控。平台把所需的變更連同建議方案提交給 DBA,從不自行執行。
數據治理與合規負責人
元數據目錄、業務語義、驗證結論以及開發與運行的記錄隨日常運轉自動沉澱,可以直接用於數據資產入表與審計。
AI 平台負責人
一個任意智能體都可以驅動、無需人工文檔即可自舉的平台接口,可以作為 MCP 工具接入企業現有的智能體體系。
這一分工的推論
業務分析師既是需求的作者,也是交付的簽字人,智能體因此只需做加速器,不必做完全正確的決策者。一個多數時候正確、其餘情況能被驗收條件當場攔下並交回給人的智能體,在這一分工下已經可用。
部署、安全與集成
數據與計算留在客戶的數據庫中
數據不出域
數據存儲與大規模計算留在客戶側,平台只流轉意圖、裁決結果、記錄與元數據這類小數據:數據不出域,沒有出口費用,不被鎖定。部署支持本地、混合與跨雲。
模型不綁定廠商
企業可以使用雲端的前沿模型、區域託管的模型服務,也可以使用本地部署的模型,併為不同的開發階段選擇不同的模型。
四種集成方式
在 Python 中直接調用,作為 MCP 工具接入企業現有的智能體體系,通過 HTTP 接口供其他系統調用,以及通過 Web 控制台供人操作。四種方式調用同一套實現,結論一致。
安全原則
憑證不進入項目,只讀數據源不會被寫入,表結構變更只由 DBA 執行,裁決不受智能體影響,每一次開發與運行全程留痕。
與我們聯絡
聊聊吧。
無論您的組織在內部承擔數據交付、為客戶建設數據系統,還是有意投資,都歡迎與我們聯絡。